摘要:扫描件 PDF 内部封装着扫描仪生成的原始图像,无需二次渲染压缩。采用原图直提模式,本地离线批量导出,实现档案画质零损耗,兼顾数据安全与大批量处理效率。
一份 300 页档案扫描件,遇上紧迫的工作截止时间。
“这批档案明天上午要完成 OCR 全文识别,先把 PDF 批量转为图片。”
不少档案从业者第一反应就是上网搜索 PDF 转图片工具。在线平台操作看似简单:上传档案、等待处理、下载结果,实际落地却难题重重。
⚠️ 页数限制:免费工具普遍存在页数限制,大批量档案处理必须付费开通会员;
⚠️ 画质受损:转换完成后图像发虚蒙雾,档案字迹、印章细节受损,直接拉低 OCR 识别准确率;
⚠️ 体积失控:文件大小两极分化,要么图片体积暴涨占用大量存储,要么强行压缩丢失归档关键细节;
⚠️ 安全风险:涉密与内部档案严禁上传至第三方外网服务器。
档案馆、档案室、图书情报机构、企业文档岗位,几乎都会碰到这类现实痛点。 有没有面向档案业务,✅本地批量处理、✅画质无损、✅老旧办公设备也可稳定运行的解决方案?
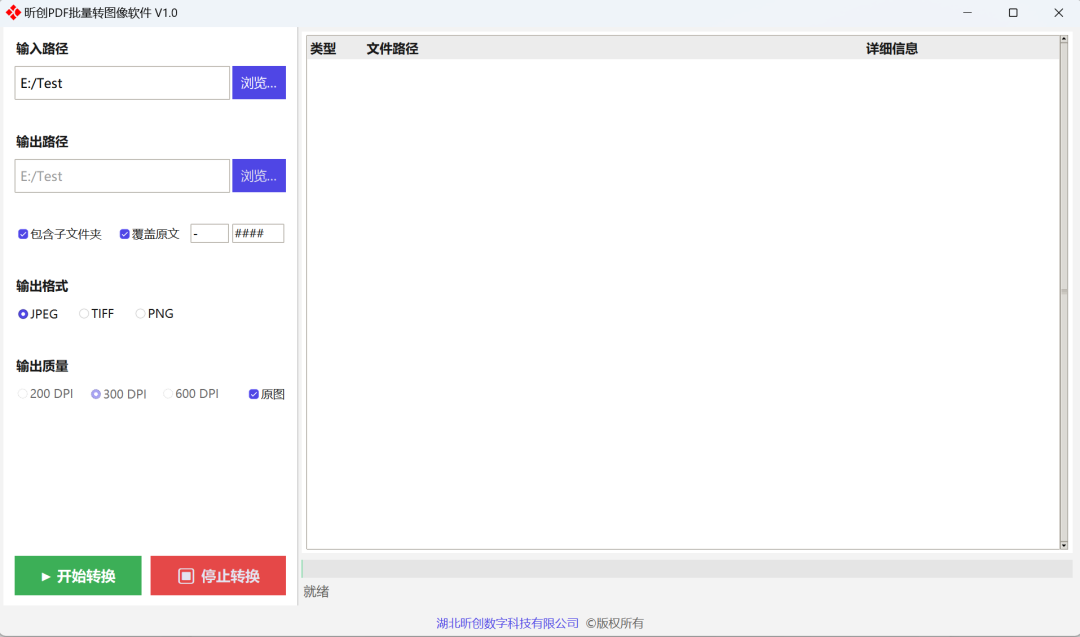
「昕创 PDF 批量转图像软件」,专为档案扫描件 PDF 转图像场景打造。
📌多数转换工具,都在对档案 PDF 做 “重新拍照”
扫描件转图画质劣化,根源在于转换逻辑。 市面上绝大多数工具采用重新光栅化机制:把 PDF 每一页虚拟模拟成纸质页面,重新渲染生成新图像,再做压缩输出。
这套 “重新拍照” 的处理流程,会带来两个难以规避的问题:
🖼️ 档案画质不可逆损失:重采样叠加有损压缩,笔画边缘、印章纹路、表格细线等档案关键细节被抹除,不符合档案影像归档保真要求;
📦 画质和文件体积两难取舍:想要图像清晰,文件体积就会急剧膨胀;想要控制存储占用,就必须牺牲图像质量。
对于档案工作来说,影像保真属于硬性业务标准,这样的取舍本就不该存在。
💡核心认知:扫描件 PDF 内部,原始扫描图像一直都在
扫描生成的 PDF 文件,本质就是将扫描仪输出的原始图片打包封装在 PDF 容器内,原始 JPEG、TIFF 图像完整内嵌于文件当中。 档案所需的高清原图本就存放在 PDF 内部,完全不需要重新渲染生成。
最优的转换逻辑,不是二次绘制图片,而是直接提取 PDF 内嵌原始图像。
「昕创 PDF 批量转图像软件」默认开启原图直提模式,直接读取 PDF 内部原始图像数据流,全程不进行二次重编码。
✅ 画质零损失:导出图像与扫描仪输出源文件完全一致,完整保留档案全部细节;
✅ 体积不膨胀:原始图像多大,导出文件就多大,不会因为转换操作额外增加存储空间占用;
✅ 处理效率更高:跳过复杂渲染计算环节,数百页档案仅需几分钟即可完成处理。
📝兜底兼容机制:如果页面为纯文字矢量内容,不存在内嵌扫描原图,软件将按照自定义 DPI 自动渲染输出,杜绝空白页、漏页问题。
🛠️面向档案业务的实用能力集合
🎯三档 DPI 自由选配
200 DPI|标准档,适用于阅览查看、网页挂接;
300 DPI|高清档,适配打印、OCR 预处理(档案场景默认推荐);
600 DPI|超清档,用于高精度打印、永久保存级档案归档。
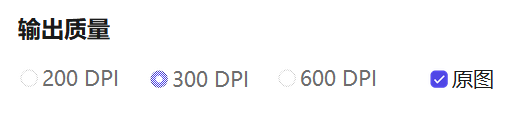
💡小提示:OCR 预处理优先选用 300DPI,识别收益最高,过高 DPI 会成倍增加处理耗时。
📂三种行业常用输出格式
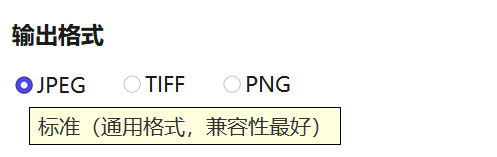
JPEG:通用性强,绝大多数档案业务系统兼容;
TIFF‑LZW 无损压缩:档案行业长期归档首选格式;
PNG:无损高清,用作中间处理素材。
🚀真正的大批量文件夹级批量处理
支持直接拖拽整个文件夹,一次性处理成百上千份 PDF;
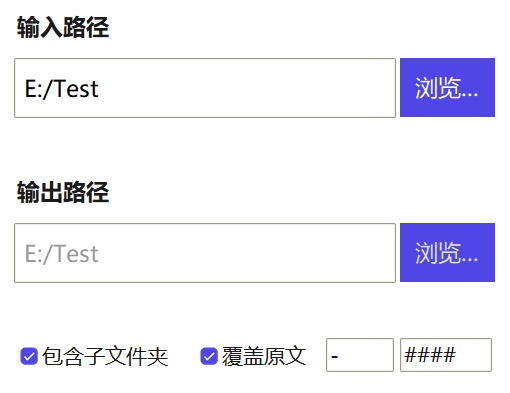
勾选「包含子文件夹」,可递归处理多层嵌套目录;
实时展示转换进度(已处理页数 / 总页数),支持随时中止任务;
处理日志表格直观呈现每一份文件结果,异常失败标红提示,日志可导出留存,便于工作回溯上报。
🏷️自定义命名规则,无缝对接档案系统支持自定义连接符 + 序号输出命名规则,导出图片命名规整统一,无需手动修改,直接对接档案管理系统入库。
🔒全本地离线运行,保障档案数据安全软件完全离线工作,无需联网,不会上传任何档案文件,所有数据仅保存在本机硬盘,满足政务、涉密档案使用要求。
🖥️绿色免安装,兼容老旧办公主机单 EXE 程序,双击直接运行,无需部署 Python 运行环境;兼容 Windows10/11(64 位),单位老旧办公电脑同样可用。
📝三步快速完成档案 PDF 批量转图
第 1 步|选定输入输出路径
输入路径:选择 PDF 文件或者文件夹,支持拖拽导入; 输出路径:指定图片导出存放目录。
第 2 步|配置业务参数
选定输出格式 JPEG/TIFF/PNG; 设置 DPI 分辨率; 保持「原图」模式默认勾选,启用零重编码提取。
第 3 步|启动转换
点击开始转换,进度条与处理日志实时更新,任务结束前往输出目录核验成果。
✨使用小提示:正式大批量作业前,建议选取 2‑3 份 PDF 做测试,确认画质、命名规则无误后再全量执行。
🎯适用业务场景
🏛️档案馆 / 档案室:扫描件 PDF 提取原图,OCR 预处理、影像归档、档案系统挂接;
📋政务窗口:存量业务 PDF 材料批量转图,对接上级业务平台;
📚图书情报机构:古籍、报刊数字化资料图像批量导出;
💼企业文档管理:合同、票据档案批量影像化归档;
🔬教育科研:试卷、文献资料批量导出图像素材。
只要你需要大批量将 PDF 转为图片,同时看重图像保真与数据安全,这款工具就能够解决实际工作痛点。
✍️写在最后
PDF 转图像看似是很小的操作,一旦踩坑,往往会耗费档案人员大半天时间。 我们开发这款工具的出发点很朴素:既然原始扫描图像已经封装在 PDF 内部,就不要再反复损耗它。把原图提取出来、规整命名、妥善保存,把人力解放出来投入更有价值的档案业务工作。